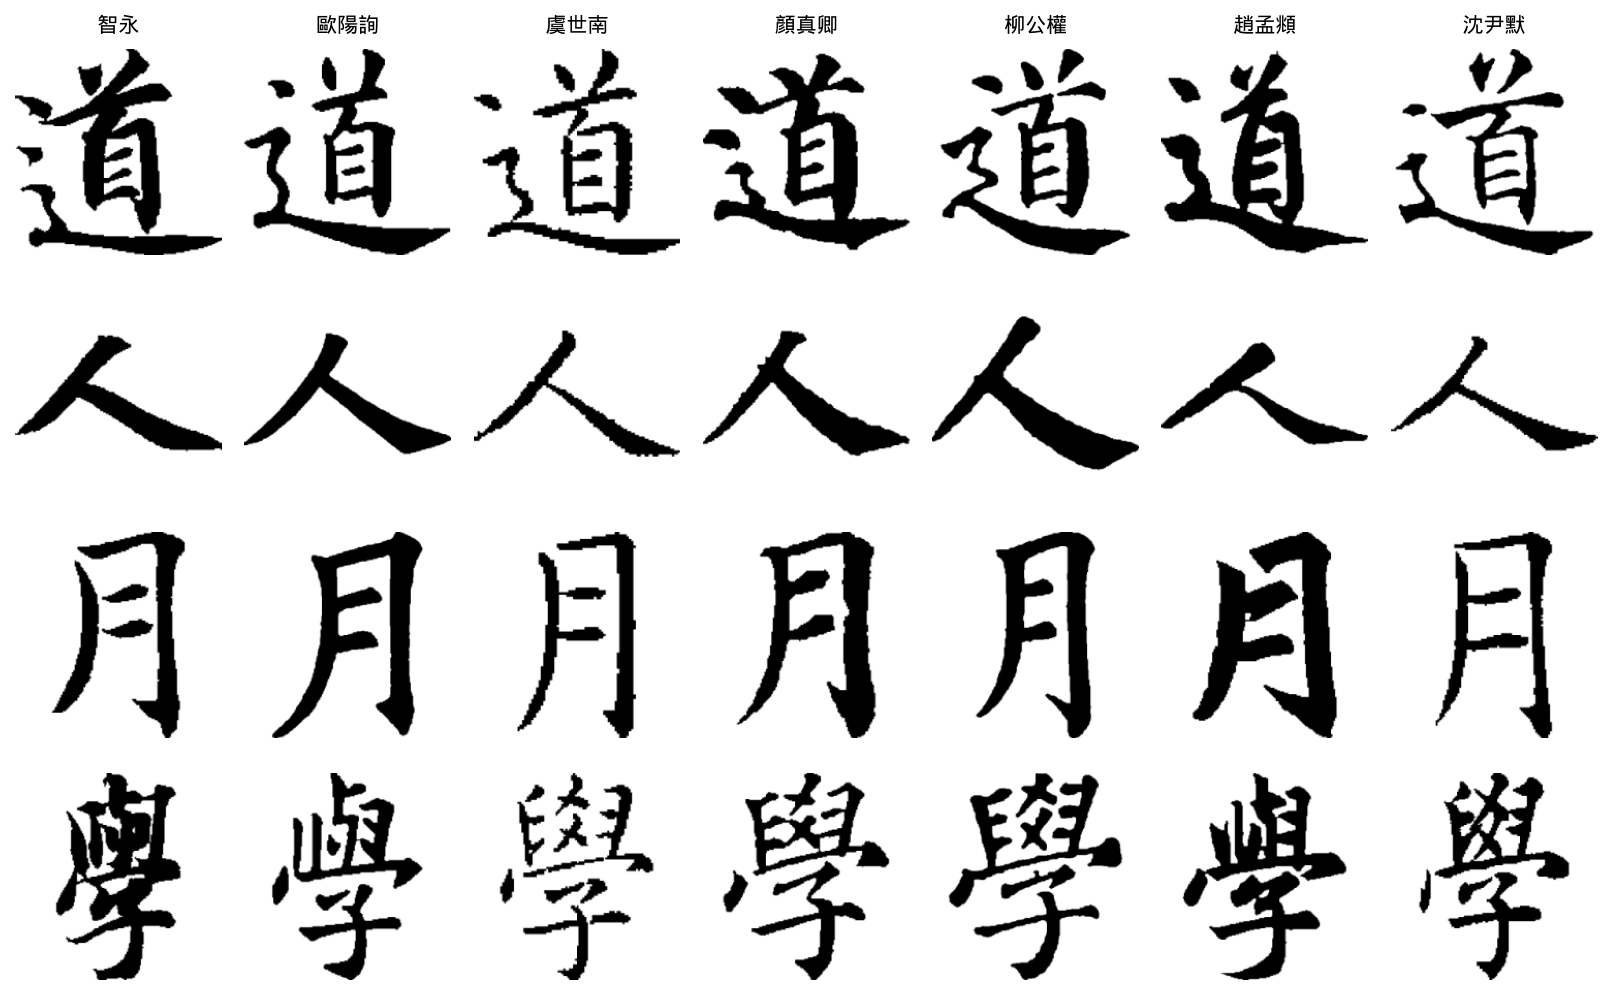
本平台背後是一項書法風格量化研究。核心問題是:書法家的個人風格, 在影像的哪個尺度上被承載?我們整理了一組同字跨書法家配對的資料集, 以頻域方法檢驗傳統書論「結構為本、筆法為末」的說法, 並將所得理解用於風格生成任務。
所有實驗採 character-disjoint 評估:測試所用的字在訓練階段完全未出現, 模型無法藉由記憶特定字與書法家的共現關係取得優勢。
發現一:身份訊號集中於低頻結構
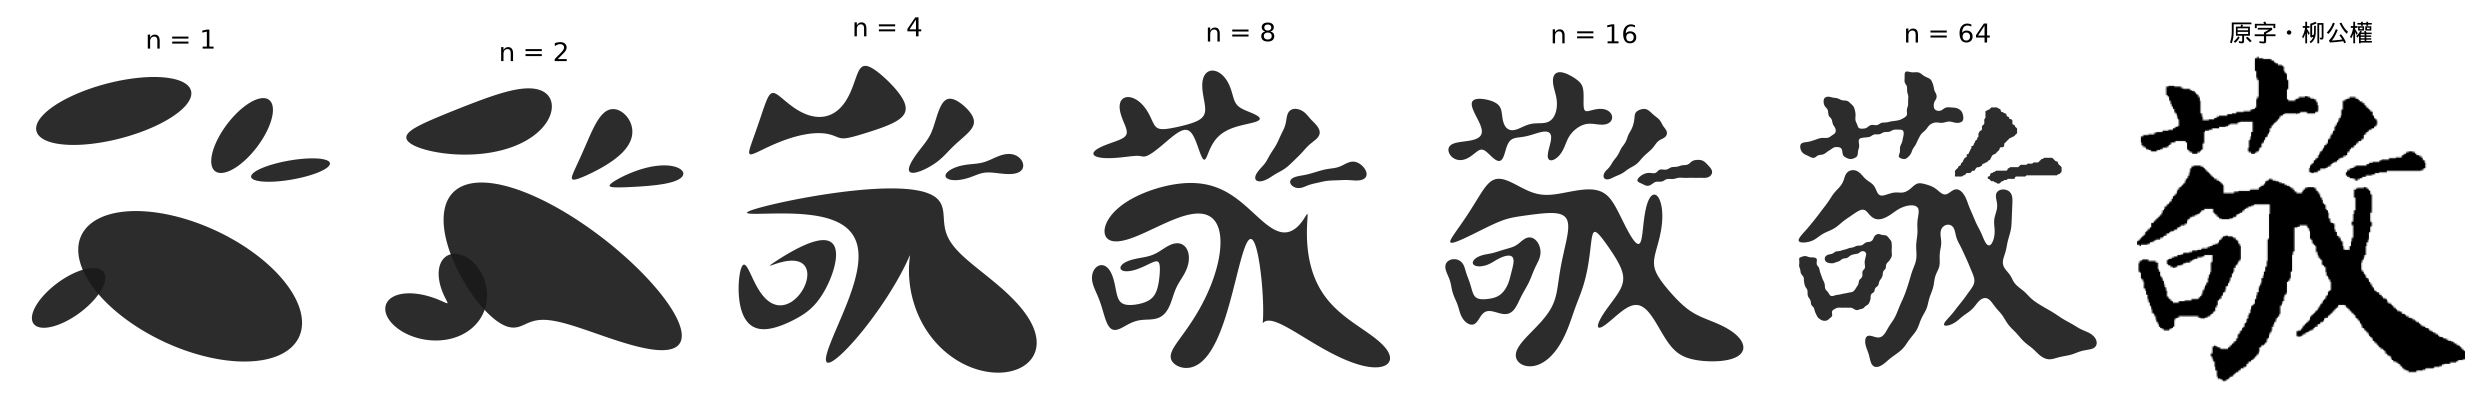
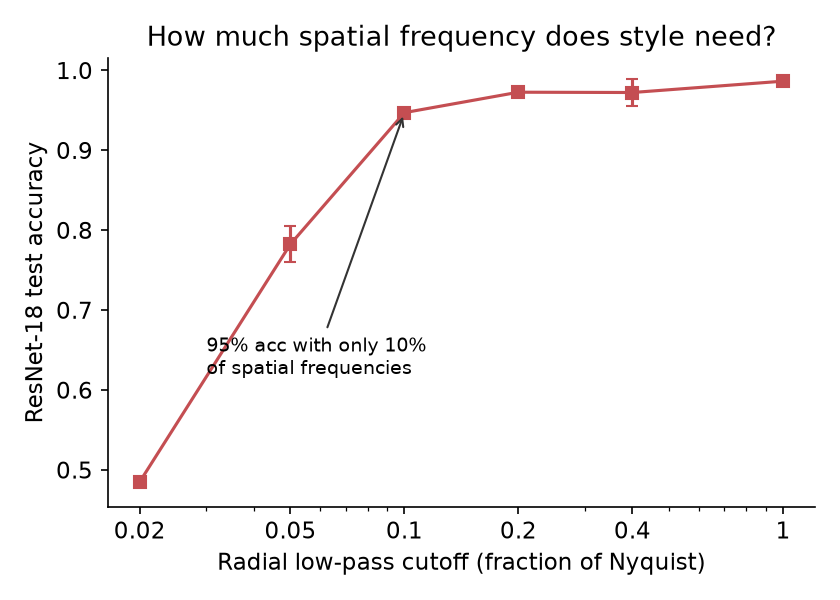
對字圖施加徑向低通濾波後重新訓練分類器:僅保留最低 10% 的空間頻率 ——粗略的筆畫佈局、無任何筆鋒細節——辨識準確率即達 94.7%, 其餘 90% 的高頻成分僅額外貢獻約 4 個百分點。
| 保留頻率半徑 | 2% | 5% | 10% | 20% | 100% |
|---|---|---|---|---|---|
| 辨識準確率 | 48.5% | 78.2% | 94.7% | 97.3% | 98.7% |
發現二:風格表徵可跨字、跨字帖泛化
同字配對驗證任務:給定兩張同一個字的影像,判斷是否出自同一書法家。 深度風格表徵在未見過的字上達到 ROC-AUC 0.998; 將正例限制為「不同字帖」的配對後仍有 0.989, 顯示模型學到的是風格本身,而非特定字帖的再製特徵。
| 表徵 | 訓練 | ROC-AUC |
|---|---|---|
| 手工特徵(傅立葉描述子+Hu 矩+頻譜統計) | 無 | 0.635 |
| DINOv2 ViT-S/14 | 無(通用自監督) | 0.793 |
| ResNet-18 style embedding | 本資料集訓練字 | 0.998 |
發現三:可解釋特徵承載約一半訊號
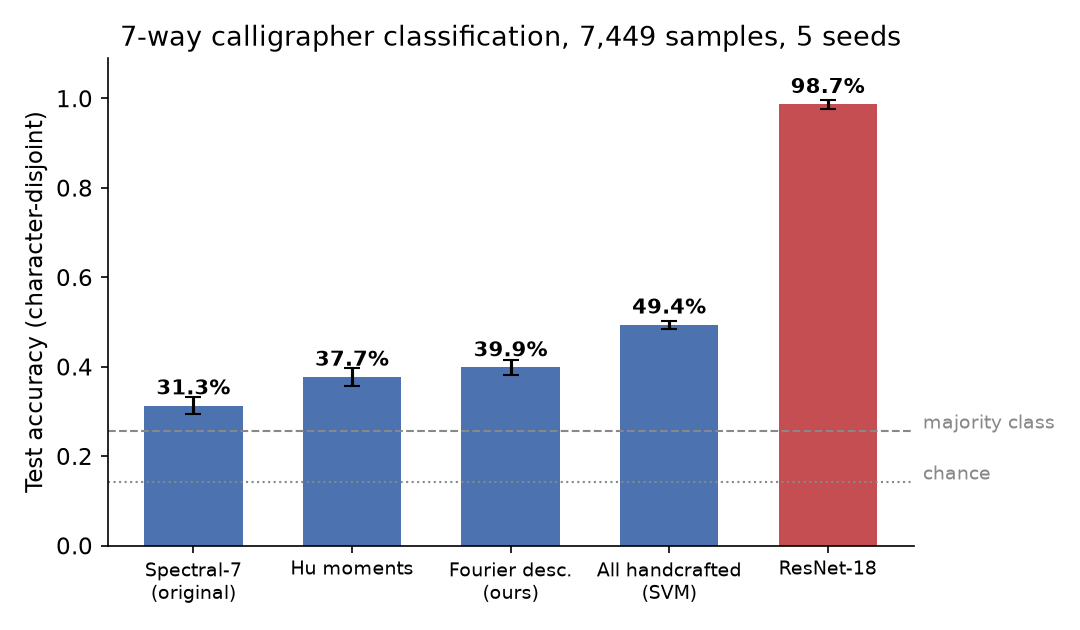
三組手工特徵串接後達 49.4%(多數類基準 25.7%), 深度特徵則為 98.7%。手工特徵具互補性,但涵蓋範圍有限; 此一落差本身即為後續分析的對象,而非單純的效能差距。
發現四:跨資料集泛化才是難點
在獨立蒐集的 40,152 張外部影像上,準確率降至 32.0%。 分析顯示筆畫寬度為主要干擾因素:外部的細筆畫影像集中被判為本資料集中筆畫較細的類別。 經骨架化與固定寬度重繪後回升至 37.1%,其中顏真卿自 16% 回升至 75%。 同源辨識容易、跨源泛化困難——後者才是此任務的實際難點。
發現五:生成任務中的結構鴻溝
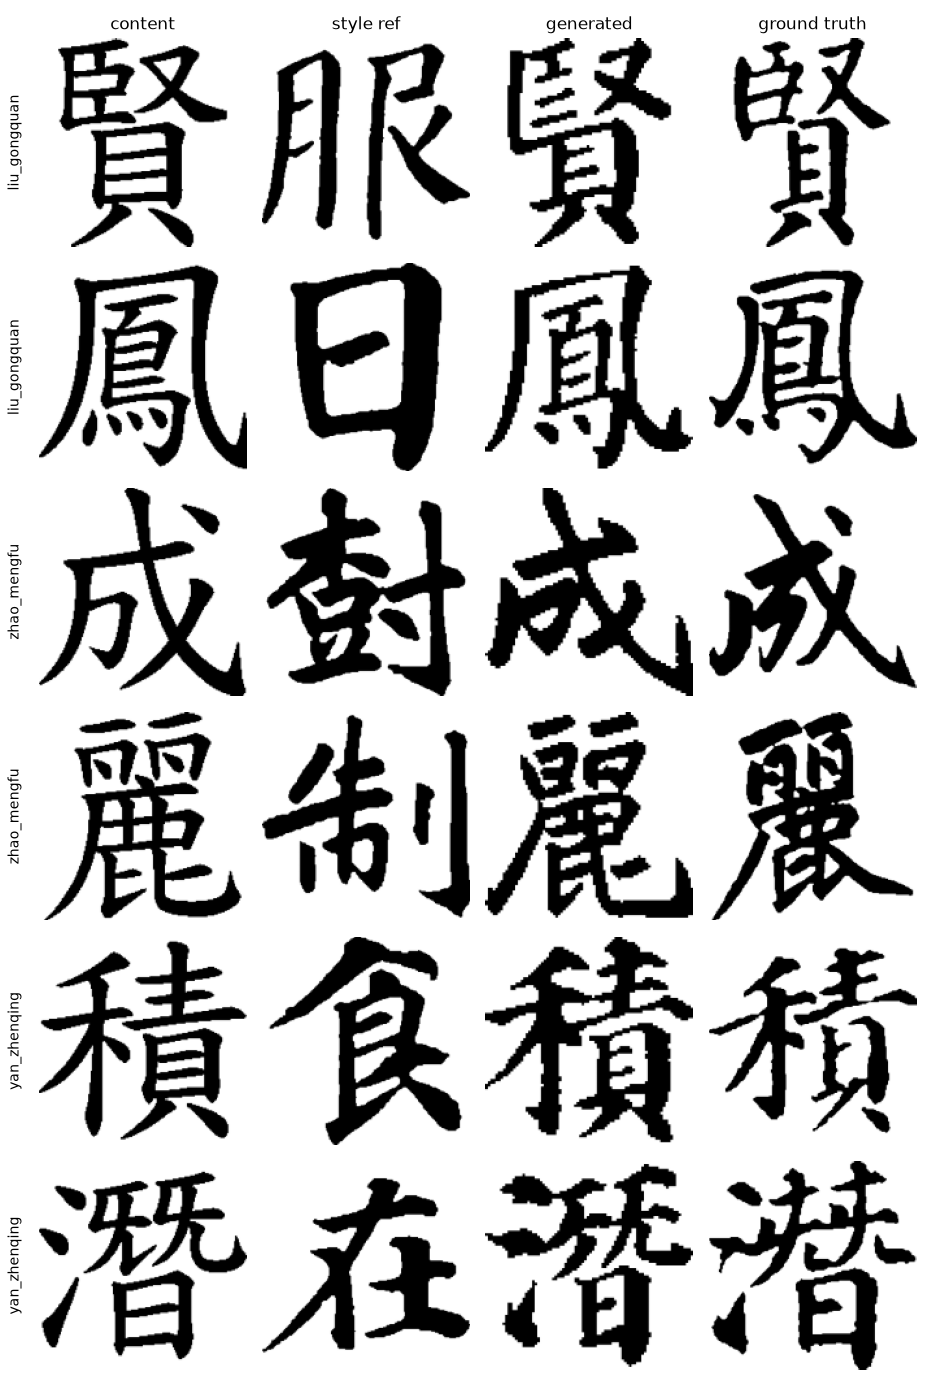
我們將同一框架用於檢驗風格生成。評估利用本資料集的獨有條件: 保留該書法家確實寫過但未參與訓練的字作為 ground truth。 六項介入(微調、頻域結構損失、類別平衡、guidance 調校、驗證導引重排) 均在 34% 附近趨於飽和。
| 設定(凍結評估器,真跡上限 91.9%) | Style match | SSIM |
|---|---|---|
| zero-shot | 20.0% | 0.531 |
| + 本資料集微調 | 32.4% | 0.556 |
| + guidance 調校+驗證導引重排 | 34.3% | 0.557 |
| + 頻域結構損失(ours) | 33.3% | 0.563 |
| + 軟骨架結構損失(ours) | 33.3% | 0.552 |
依據發現一,我們設計了兩種直接約束結構的損失(頻域低頻比較、可微分軟骨架比較)。 以同一批 210 個 held-out 字做配對檢定:頻域結構損失使生成結果顯著遠離標準字骨架 (SSIM 0.5404→0.5264,p<0.001)、靠近真跡(0.5557→0.5625,p=0.021), 內容洩漏率自 39.0% 降至 28.6%(p=0.030)——結構鴻溝確實被縮小了。 但分類器判定的風格辨識率並未隨之提升。兩項指標的分歧本身即為一項發現: 縮小結構鴻溝是必要條件,卻不足以讓生成結果被辨識為該書法家。
- 資料為既有碑帖翻攝之策展成果,非原始拍攝。
- 同源辨識準確率有一部分來自字帖再製特徵;跨字帖與跨資料集結果為較保守可靠的指標。
- 資料集以楷書為主,結論未必可推廣至行書與草書。
- 平台的臨帖診斷指標尚未經書法專家評分驗證。